
この記事は、2026/08/19に公開された「Eliminating the Enterprise AI Governance Bottleneck with Cloudera Agent Studio 3.0」の翻訳です。
企業は、非常に価値が高く差別化された AI エージェントの本番環境への導入を積極的に進めています。 しかし、最も価値の高いエージェントは、組織が管理を失うわけにはいかないデータ、つまり機密性の高い独自データに依存しています。
その結果、すぐにガバナンス面での問題が発生することになります。多くの従来型アーキテクチャでは、エージェントがデータを利用する前に、管理対象のストレージから外部の SaaS プラットフォームへデータを移動する必要があります。移動した瞬間、組織はデータソースでデータを完全に管理する能力を失い、以下の3つの複合的なリスクを負うことになります。
セキュリティ:エクスポートするたびに機密データの外部コピーが作成され、攻撃対象領域が拡大します。その結果、チームは信頼できる唯一の情報源とは別に、並行するデータセットを管理し、パッチを適用し、監査する必要があります。
パフォーマンス: 外部プラットフォームとの間でデータを往復させるとレイテンシが発生し、マネージドストレージに組み込まれたクエリ最適化が失われるため、エージェントの実行速度は基盤インフラストラクチャが可能にする速度を大幅に下回ります。
コスト:大規模にクラウドの境界を越えてデータを抽出すると、エグレス料金が増加します。エージェントのワークロードは一度だけでなくデータを繰り返しクエリするため、多くの場合、料金は予測できません。
真に差別化された価値を生み出すために必要なデータとAIは、私たちの管理下を離れた場合に最も高いリスクを伴うものでもあることが少なくありません。 その結果、こうしたリスクを評価するコンプライアンスおよびセキュリティチームは、概念実証の段階を終えたばかりの有望な取り組みを中断させる形で、介入を余儀なくされることがよくあります。
本番環境への AI 導入における5つの構造的障壁
推論型 LLM とツールインターフェース、構造化されたタスク計画、および継続的な実行ループを組み合わせたエージェント型ワークフローは、本質的に、隔離されたインフラストラクチャ上で安全に動作できません。エージェント型ワークフローは、管理されたデータ基盤向けの計算リソースに直接アクセスできる環境を必要とします。断片化されたデータ移動環境に追い込まれた組織は、以下の5つの障害に直面します。
ブラックボックス化した自律性と監査上の責任問題:自律的な複数ステップの意思決定は、規制リスクを生み出します。 標準的なシステムログではエンドポイントの呼び出しは記録されますが、内部のサブエージェントによるタスク計画、特定のツールペイロードの入出力、各ステップの背後にある認証済みユーザー IDは 見落とされます。
サイロ化したチーム間でのガバナンスのずれ: ビジネスチームが監視されていない SaaS ツールでビジュアルプロトタイプを作成する一方、エンジニアが別々の環境で独自の Python オーケストレーションスクリプトを作成すると、技術アーキテクチャが分断されます。 この二面性は、集中的なアクセス制御を回避し、ガバナンスのずれを引き起こします。
脆弱なプロンプト設計と実行時の再試行: 従来のエージェントフレームワークでは、構造化されていないテキストプロンプトを通じてモデルに指示を与えます。 LLM が構造化されたペイロード・スキーマではなく自由形式のテキストを出力すると、実行チェーンが破綻します。 システムによる再試行は、追加の API トークンを消費し、クエリのレイテンシを増大させ、複数ステップの実行経路全体で障害を引き起こします。
クラウドのエグレス料金とトークン消費量の増加:運用データセットをクラウドの境界を越えて外部ホストに抽出すると、データエグレス料金が継続的に発生します。 未構造化でキュレーションされていないコンテキストを外部LLMのコンテキストウィンドウに渡すと、クエリごとにトークン使用量が増加し、推論精度が向上しないまま、クエリあたりの推論コストが上昇します。
API ロックインと固定コンピュートコスト: オーケストレーションロジックを独自のモデル API にハードコーディングすると、企業は固定のコンピュート価格に縛られることになります。 インフラストラクチャチームは、定型的な関数呼び出しをより低コストなローカルパラメータモデルにルーティングし、複雑な推論にはサードパーティのフロンティア API を確保するという柔軟性を失います。
Cloudera Agent Studio がガバナンスの効いた実行を実現する方法
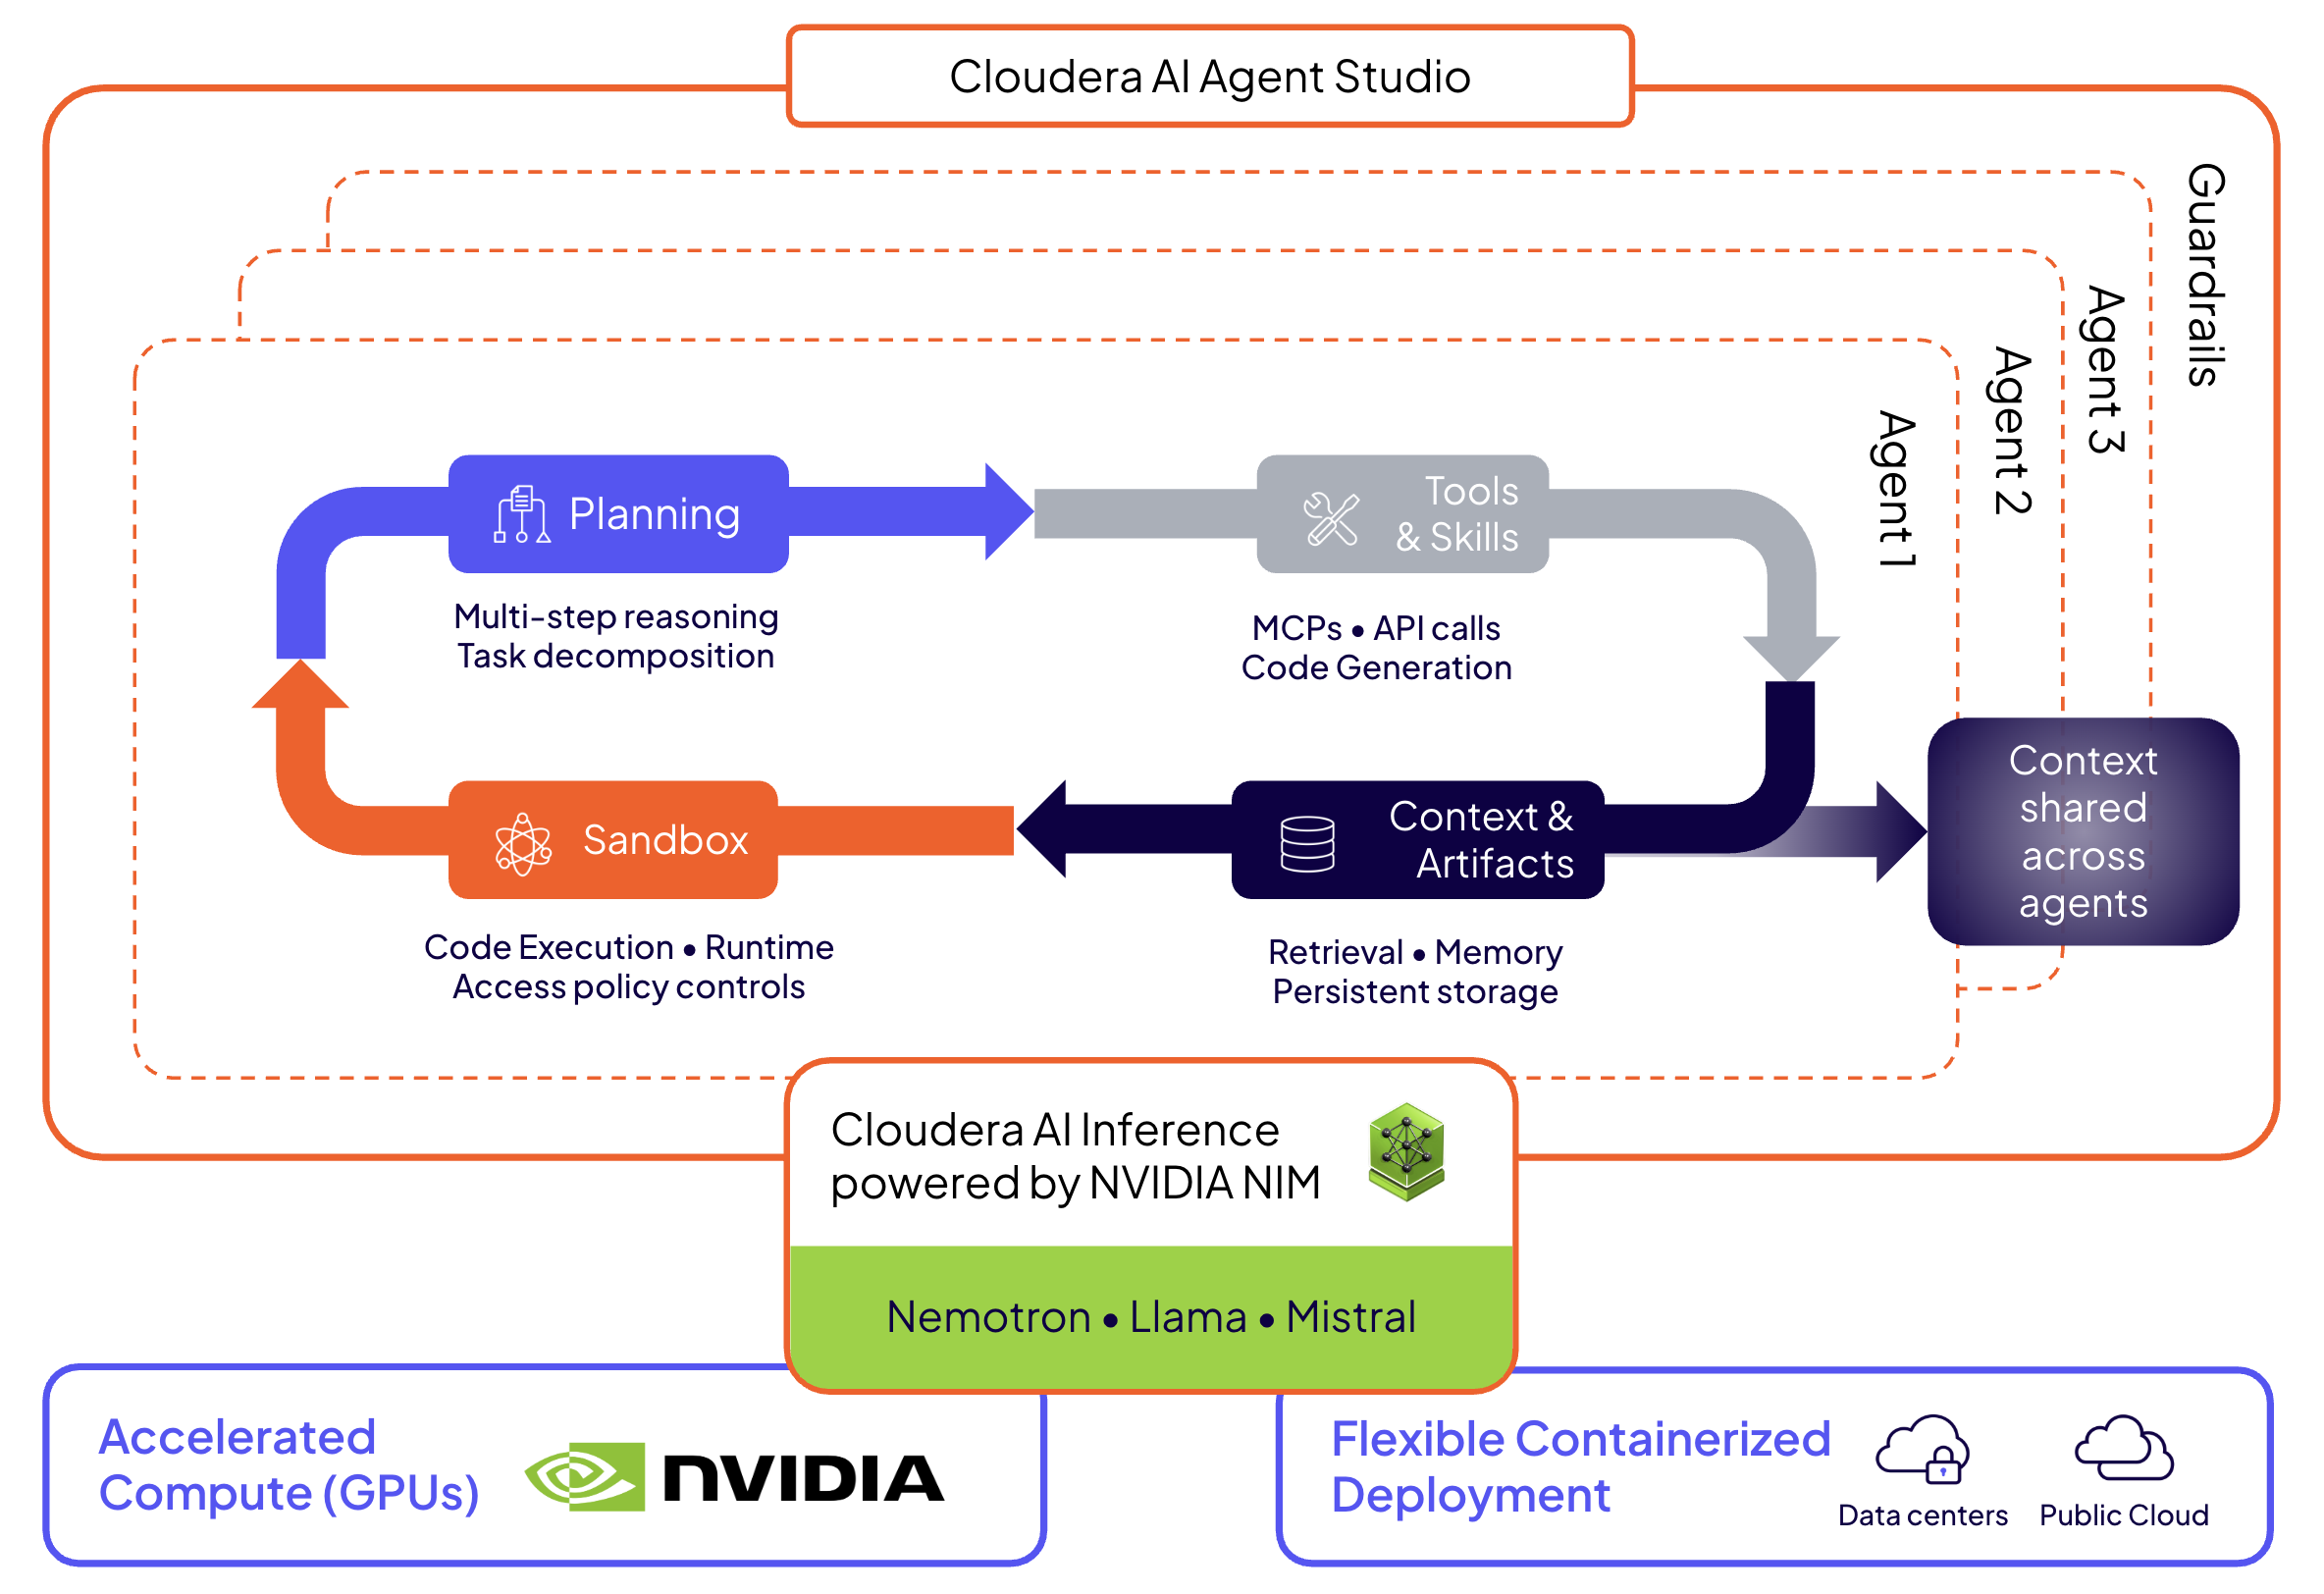 Agent Studio 3.0 アーキテクチャ
Cloudera Agent Studio 3.0 は、データが存在する場所で自律型 AI ワークフローを直接実行することで、こうした構造的課題を解決します。既存の Cloudera データサービス基盤上で動作する、ガバナンスが効いた実行エンジンを提供し、5つの構造的障壁をそれぞれ体系的に取り除きます。
1. 改ざん不可能な監査ログ & ガードレール
ブラックボックス化した自律性と監査上の責任問題を解決する
規制リスクを軽減し、ブラックボックス化された実行を排除するために、システムアクティビティは構造化された追記専用の監査ログに記録されます。 コンプライアンスチームは、認証されたユーザー ID、マイクロ秒単位のタイムスタンプ、操作タイプ、リソース識別子、プロンプト入力、特定のツール出力を捕捉するエンドツーエンドの可視性を確保できます。
動画:リアルタイムガードレールの動作例
実行の安全性は、以下のリアルタイムのメカニズムによって継続的に確保されます。
PIIのマスキング:モデルのコンテキストウィンドウに送信する前に、機密データを匿名化します。
コンテンツフィルター:プロンプトインジェクションを防止したり、キーワードに基づいて実行をブロックしたりする、テキストベースの決定論的なルールです。
インライン LLM 審査員:企業のコンプライアンス規則に照らして、ツールペイロードの入力と出力を検証します。
カスタム・ガードレール: ビジネス要件に合わせたガードレールをプログラムで適用します。
詳細については、当社のガードレールのドキュメントをご覧ください。
2. 統合型デュアルトラックワークフロー
サイロ化されたチームにおけるガバナンスの乖離を解決する
Agent Studio 3.0 は、非技術系開発と技術系開発を単一のオーケストレーションエンジンに統合し、ビジネスチームとエンジニアリングチーム間のアーキテクチャ上の分断を解消します。
ビジネスアナリスト向け:事前構築済みのツールテンプレートと MCP コネクターのカタログを使用して、ワークフローを視覚的に構築できます。
AIエンジニア向け: Cloudera AI Workbench でカスタム Python ロジックを記述します。
どちらの経路も同一の実行ランタイムにコンパイルされるため、プラットフォームのセキュリティ制御を共有し、シャドーAIのガバナンスのずれを解消します。
3. 制御可能な関数呼び出し&サンドボックス化
不安定なプロンプトと実行エラー発生時の再試行を解決する
脆弱なテキストプロンプトによる実行チェーンを解消するため、プラットフォームはネイティブの LLM 関数呼び出しプロトコルを活用します。正式な JSON スキーマをモデルに渡し、厳密に型付けされたツール呼び出しオブジェクトを生成します。
コンテナのサンドボックス化:エージェントの各プロセスは、デフォルトでシステム権限が一切付与されないように設定された隔離コンテナ・サンドボックス内で実行されます。権限昇格には、プラットフォームレベルのポリシーによる明示的な承認が必要です。
構造化された計画:実行前に、エージェントは構造化されたタスク計画を作成し、オペレーターが各ステップの進捗を決定論的に監視できるようにします。
4. MCP を介した管理対象データ上でのローカルコンピューティング
クラウドのデータ搬出料金とトークンインフレを解決する
エージェントは、データの抽出や複製を行うことなく、エンタープライズストレージに対して直接実行されます。また、Cloudera Data Warehouse の構造化分析クエリを実行し、Cloudera DataFlow を通じてストリーミング入力を処理し、出力を Cloudera Data Visualization にプッシュします。
Model Context Protocol(MCP)を使用するコネクタは、エージェントをオープンテーブル形式に直接接続します。一方、Cloudera Shared Data Experience(SDX)のガバナンスポリシーは、ロールベースのアクセス制御を適用し、あらゆるやり取りでメタデータを追跡することで、データの文脈を保ち、エグレス料金をゼロに抑えます。
5. モデルの中立性とFinOps管理
API ロックインと固定コンピューティングコストを解決する
Agent Studio 3.0 は、オーケストレーションを基盤となる言語モデルから完全に分離します。 チームは、Cloudera AI Inference サービスを通じて、サードパーティ API(OpenAI、Anthropic、Amazon Bedrock)を対象にするか、オープンソースモデルをローカルにデプロイできます。
モデルターゲットの切り替えには、エージェントコードやツールスキーマを変更せずに、オーケストレーション層のエンドポイント構成を更新する必要があります。 システムアーキテクトは、定型的で大量の関数呼び出しを小規模なローカルホスト型パラメータモデルにルーティングし、高コストなサードパーティ API トークンは複雑な複数ステップの推論に限って使用することで、総所有コスト(TCO)を削減します。
定量化されたビジネス成果
業界 |
運用シナリオ |
ビジネス価値 |
金融サービス |
1億件を超えるレコードを含むデータセットを横断して、信用情報が限られた法人顧客の与信審査を行います。 |
引受審査のサイクルを数日から数分に短縮するとともに、規制当局の要件に対応した監査証跡を生成します。 |
通信 |
Data Flow を介して毎秒50,000件を超えるストリーミングイベントを処理し、解約の兆候を検出します。 |
運用システムからデータを移動することなく、リアルタイムでデータ保持ワークフローを自動的に起動します。 |
ヘルスケアとライフサイエンス |
多様な医療記録にまたがる非構造化臨床記録から診断コードを抽出してください。 |
エアギャップ環境のランタイム内で、臨床試験のデータ処理を加速します。 |
保険 |
非構造化の物件現地調査データを、基幹トランザクションデータベースと関連付けます。 |
見落とされていたリスク要因を特定し、システム間のデータ照合を自動化します。 |
ソフトウェアとテクノロジー |
サンドボックス化されたコンテナランタイム内で、レベル2の本番環境インシデントのトリアージを実行してください。 |
人間へのエスカレーションを必要とせずに、アプリケーションのアラートを解決し、システム状態のパラメーターを更新します。 |
ガバナンスが適用されたエージェント型 AI の未来
自律型ワークフローを隔離されたプロトタイプから本番システムへ移行するには、迅速なイノベーションと企業による管理の間にある摩擦を解消する必要があります。長い間、概念実証と実用化の間のギャップにより、チームは自律型 AI の俊敏性と、中央集権型ガバナンスのセキュリティのどちらかを選ばざるを得ませんでした。
Cloudera Agent Studio 3.0は、このギャップを埋めます。
データが存在する場所で直接コンピューティングを実行することで、Agent Studio 3.0 は本番環境での AI 導入を阻む主な5つの障壁、すなわちクラウドのデータ搬出料金、実行の不安定さ、ガバナンスのずれ、監査の不透明さ、コンピューティングのロックインを体系的に解消します。企業向けエージェント型 AI の導入に、アーキテクチャ上のトレードオフはもはや必要ありません。
AI エージェントを本番環境に導入する準備はできていますか? 全7回のエンタープライズ AI とエージェント型 AI のウェビナーシリーズで、開発から本番環境への移行に役立つ戦略とスキルを身につけましょう。

