
この記事は、2026/08/11に公開された「How Cloudera and Pulse enable document AI at scale」の翻訳です。
エンタープライズ AI におけるドキュメントデータのボトルネック
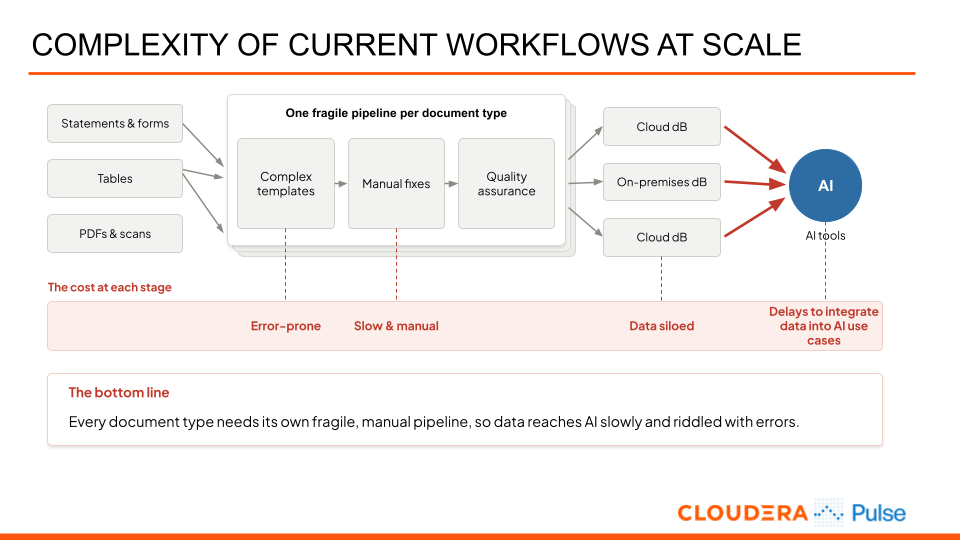
非構造化データは企業データ全体の約80%を占めていますが、データ分析や AI のユースケースでは十分に活用されていません。組織では、従来の光学文字認識(OCR)ツールや汎用の大規模言語モデル(LLM)では大規模かつ正確に処理するのが難しい、複雑な PDF やスキャン記録が急増しています。従来のアプローチは、脆弱なテンプレートベースの OCR に大きく依存しているため、文書のばらつきや手書き文字、画質の悪いスキャンに対応できず、手動レビューに大きなボトルネックが生じます。一方、汎用 LLM は文書構造を失い、出典を示せず、数値を捏造してしまう現実的なリスクを伴うことがよくあります。さらに、重要なデータは、断片的で粗雑なセキュリティモデルを特徴とするアーキテクチャ上のサイロに閉じ込められたままになってしまいます。
これらの課題により、文書データをAIのユースケースに統合することが困難になります。これは、規制上のリスクにつながり得る高いエラー率(例:保険金請求ファイルの補償限度額を読み違えることで法的責任を問われるリスク)と、文書の抽出・処理にかかる高い単位コストが、大量の文書データを AI/ML のユースケースに導入する妨げとなるためです。 さらに、手作業によるレビュー、異種スキーマを持つ分散したデータサイロ、さまざまなセキュリティガバナンスの仕組みによって、そのデータを AI/ML のユースケースで利用可能にするまでに遅延が生じます。抽出した出力を共通スキーマに標準化し、特徴量に変換するために、多数の ETL パイプラインが必要となるためです。
Cloudera と Pulse のパートナーシップ:大規模なドキュメント AI のためのリファレンスアーキテクチャ
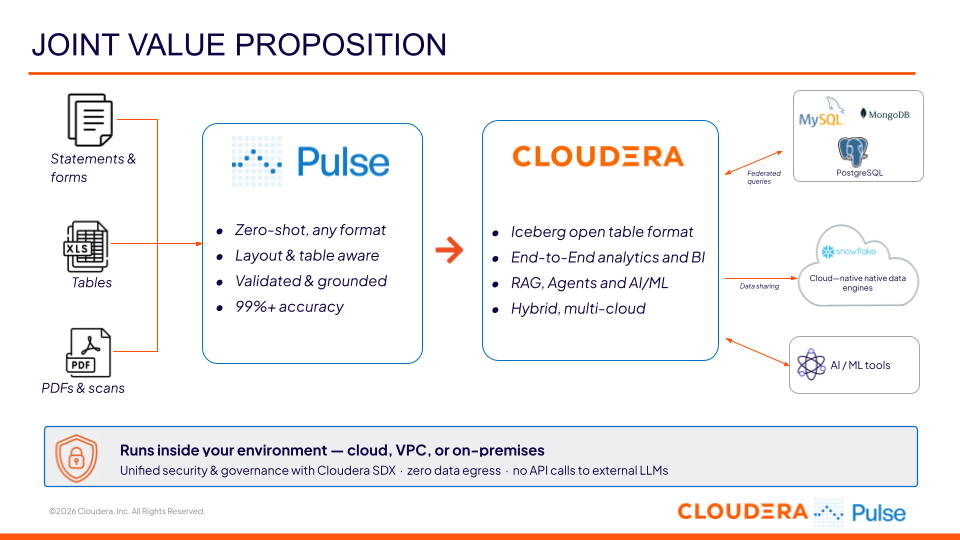
Cloudera と Pulse は提携し、従来の手法の限界を克服する大規模な文書抽出および処理ソリューションを提供します。
Pulse は、複雑な PDF、手書きメモ、表、グラフなどからデータを抽出する複数のパイプラインを、単一の多段階・多モデルパイプラインに置き換え、高精度で監査対応可能なデータを提供します。各データ抽出ステップは、その作業専用に構築されたモデルによって実行され、「Pulse Brain」は意味的な文脈と文書のレイアウトを理解し、出力前に結果を推論してエラーを検出することができます。
Cloudera は、データストリーミング、データエンジニアリング、データウェアハウス、ML・生成 AI を統合し、SDX を通じて統一されたセキュリティとガバナンスレイヤーを備えた、一元的で、オープンなデータレイクハウスおよびエンタープライズ AI プラットフォームを提供します。このフレームワークは、属性ベースのデータアクセス制御、データリネージ、アクティブなメタデータの拡充およびカタログ化といった機能を備えています。
この組み合わせにより、Pulseで処理される構造化文書データと非構造化文書データを、共通のセキュリティおよびガバナンスフレームワークの下で統合する一元的なテクノロジーアーキテクチャが構築され、異なるパブリッククラウド環境とプライベートクラウド環境にわたって単一の管理画面からアクセスできるようになります。このアーキテクチャにより、多様なデータソースにわたる特徴量エンジニアリングのワークフローを標準化し、AI/ML のユースケースで構造化データとドキュメントデータを相互に活用することが可能になります。さらに、オンプレミスまたはクラウド上の外部ツールに構造化データと文書データを提供する、統合されたデータ共有レイヤーを提供します。
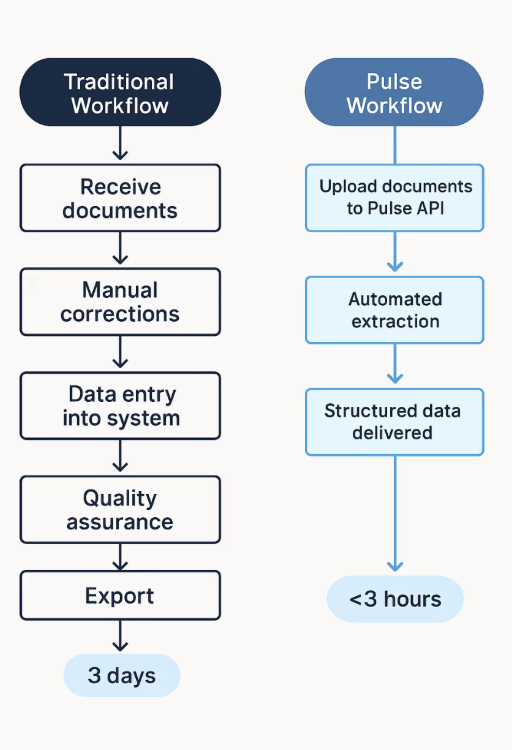
さらに、共同の価値提案により、通常は最大3日かかる手作業での修正や品質保証作業をなくし、AI のユースケースに文書データを統合するまでの時間を短縮できます。これにより、抽出にかかる時間を3時間未満に短縮できます。
Cloudera はデータエンジニアリングと LLM 推論ワークロードにおいて、それぞれ最大 20 倍 および 36 倍の改善を実現します。 同様に、Pulse は複数の GPU と CPU の最適化を活用して抽出の単位コストを最小限に抑え、GPU 使用率を 30%向上させます。
機密データおよび規制の厳しい業界向けに構築
金融サービスや医療などの規制業界では、気づかれない抽出エラーのコストは単なる品質問題ではなく、数百万ドル規模、あるいは規制上のリスクとして測られます。 たとえば、小数点の位置がずれていたり、ピリオドがカンマとして解釈されたりすると、AML/KYC 検証で重大なエラーが発生し、多額の規制上の罰金につながる可能性があります。
Cloudera と Pulse のソリューションは、機密データや規制対象業界向けに特別に設計されており、顧客の仮想プライベートクラウド(VPC)内に完全に展開できる上に、文書抽出や高度な分析のための外部へのデータ流出が一切ありません。
Pulse は、抽出されたすべてのフィールドがソースページ上の正確な位置に直接基づいていることを保証することで、本番環境レベルのデータ検証可能性を実現します。これにより、文脈と階層関係が保持され、ほぼ完璧なドキュメント抽出が可能になります。 特にスプレッドシートデータ向けに、レイアウトや書式設定の慣習、金融分野特有のニュアンスを捉え、従来のアプローチの限界(例:非表示列の除外、階層データへの対応など)を克服できます。
Cloudera のオープンデータレイクハウスは、SDX を通じてきめ細かなデータセキュリティメカニズムを提供し、ライフサイエンス分野における GxP コンプライアンスなどの厳格な規制要件に対応します。Cloudera Data Lineage は、スキャンされた未加工の文書からベクトルデータベースのエントリに至るまで、データの詳細な構造的関係を追跡し、コンプライアンス対応の追跡記録を作成します。
AI イニシアチブを強化する推進力として
AI モデルの機能が大幅にコモディティ化する中、共同の価値提案は特に AI 施策において重要です。企業にとって真の競争上の差別化要因は、モデルへの単なるアクセスから独自データへと大きく移行しています。 Cloudera と Pulse は、非構造化ドキュメントのリポジトリを高品質で実用的な資産へと変換することで、この大きな競争優位性を企業が安全に活用できるよう支援します。 Cloudera と Pulse は連携して、Cloudera RAG Studio のベクトル検索における意味的な精度を大幅に向上させ、機密性の高い独自のドキュメントデータベースを、安全なビジネスインテリジェンスと高度なエージェント型パイプラインのための包括的な基盤へと変換します。
大規模なビジネス価値の提供
企業向けの導入環境では、Pulse は従来のドキュメント抽出手法と比べて、これまでにない成果を上げています。
大手電力会社では、これまで数十年にわたりどのシステムも正確にデジタル化できなかった手書きの現場文書を1.2M件変換し、データ精度97.5%を達成しました。 大手保険ブローカーにとって、複数のオフショアチームが処理した文書データで一貫して99%の精度を実現した初のシステムであり、完全で監査可能な構造化出力の作成時間を76%短縮しました。
Cloudera の機能や Pulse プラットフォームについて詳しくご覧ください。

